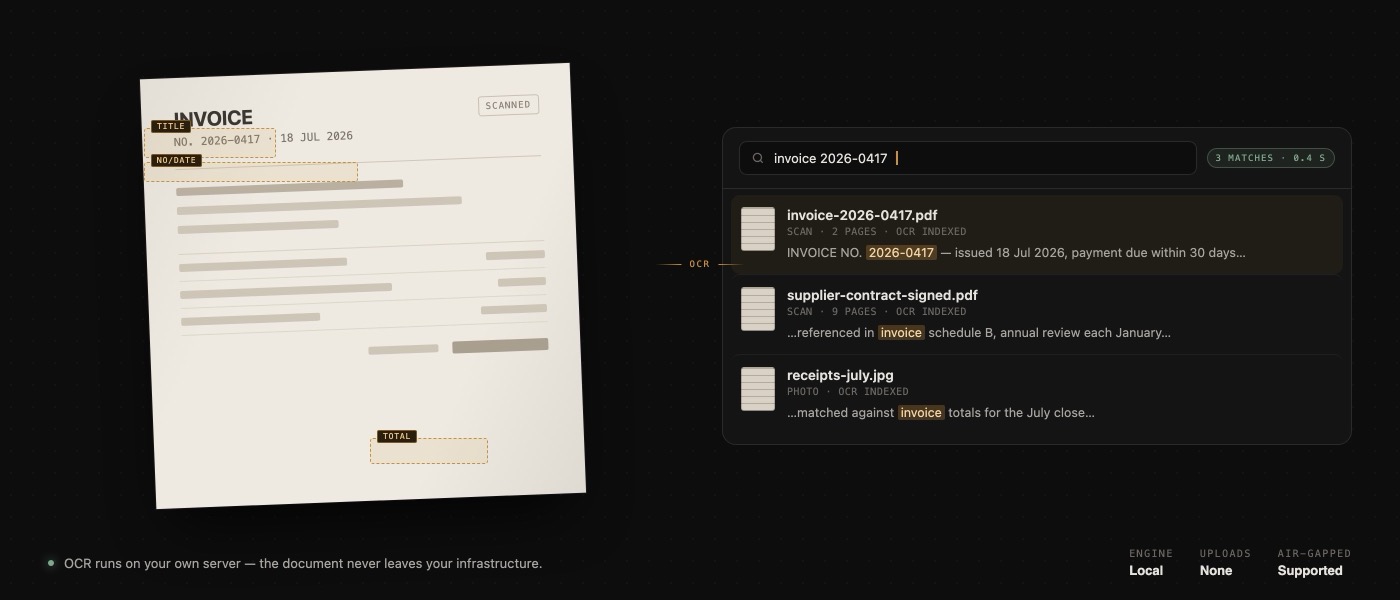
Gescannte Dokumente in Polybase sind jetzt durchsuchbar. Eine lokale OCR-Engine liest gescannte PDFs und Bilder, die in den Workspace hochgeladen werden, und extrahiert deren Text — vollständig auf dem Server, auf dem Ihr Workspace läuft. Keine Seite wird an einen externen Dienst geschickt; die Dokumente verlassen Ihre Infrastruktur nie.
Bei Scans endet die Durchsuchbarkeit normalerweise. Der unterschriebene Vertrag, die eingegangene Rechnung, die archivierte Papierakte — genau die Dokumente, die Teams am dringendsten wiederfinden müssen, kommen als Bilder von Text statt als Text. Die meisten Produkte schließen diese Lücke, indem sie die Seiten an eine Cloud-OCR-API schicken — ausgerechnet bei den Dokumenten, die am wenigsten reisen sollten, der falsche Zug.
Polybase schließt die Lücke stattdessen lokal. Sobald ein Scan verarbeitet ist, speist sein Text dieselbe Volltextsuche wie alles andere im Workspace: Die Suche nach einer Klausel oder einem Betrag findet jetzt auch die gescannte Seite, die sie enthält. Der erkannte Text steht auch in den Dokument-Viewern zur Verfügung — Text in einem Scan lässt sich finden und weiterverwenden, statt nur betrachtet zu werden.
So sieht das Souveränitätsversprechen aus, wenn es konkret wird. "Ihre Server, Ihre Schlüssel" ist bei Chat-Nachrichten leicht gesagt; halten muss es bei den schweren Fällen — dem Unterschriebenen, dem Gestempelten, dem Vertraulichen. Weil die Engine Teil des Deployments selbst ist, funktioniert sie überall dort, wo Polybase läuft — auch in selbst gehosteten und air-gapped Installationen ganz ohne ausgehende Netzwerkverbindung.
Lokales OCR ist ab sofort für gescannte Dokumente im gesamten Workspace aktiv. Wie Polybase insgesamt mit Ihren Daten umgeht, zeigt unsere Sicherheitsübersicht.
- OCR läuft lokal auf Ihrem Server — kein externer OCR-Dienst beteiligt
- Gescannte PDFs und Bilder werden volltextdurchsuchbar
- Erkannter Text steht in den Dokument-Viewern zur Verfügung
- Funktioniert in selbst gehosteten und air-gapped Deployments